Comment fonctionne la génération vidéo par IA ?
Découvrez comment l'IA transforme du texte et des images en mouvement, le rôle des modèles de diffusion et le choix d'un flux vidéo adapté.
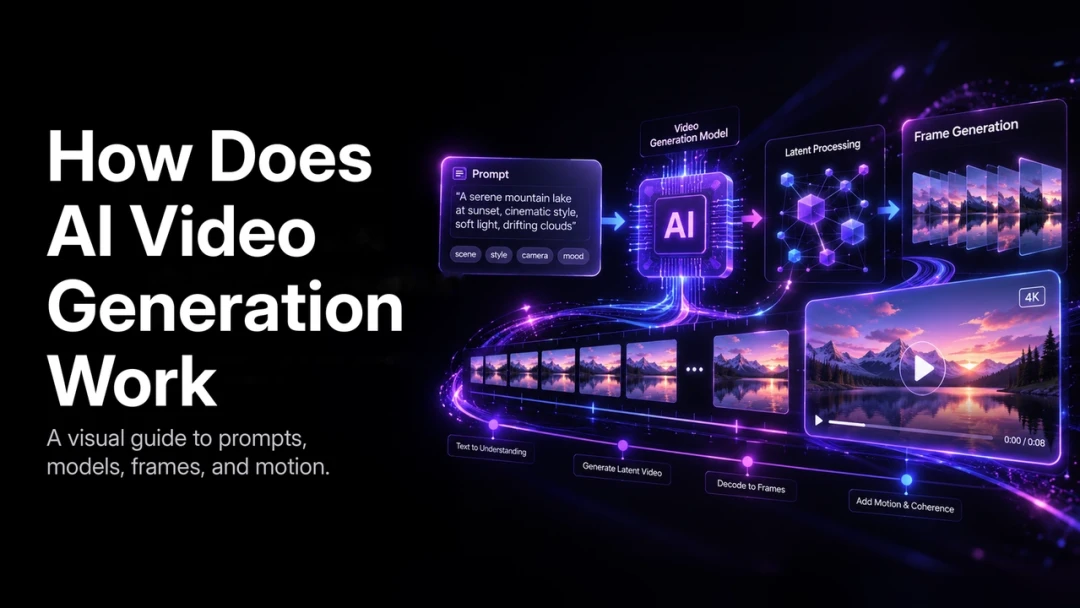
Introduction
La génération vidéo par IA transforme une idée écrite, une image ou un court clip de référence en contenu visuel animé. Au lieu d’animer chaque image à la main, les créateurs décrivent une scène et guident le modèle vers le sujet, la composition, le mouvement et l’ambiance souhaités. Le résultat peut être un concept rapide, un clip social, un visuel produit ou une partie d’un récit plus long.
La technologie est puissante, mais elle n’est pas magique. Un flux utile commence par la compréhension de l’interprétation d’un prompt, des raisons de la dérive du mouvement entre les images et du type d’outil adapté au projet.
Comment l’IA transforme une idée en mouvement
Un modèle vidéo IA relie langage, apparence et temps. Le prompt fournit l’intention ; des images ou clips de référence peuvent fixer les détails visuels ; le modèle prédit ensuite une suite d’images qui rend le sujet et l’action continus.
Par exemple, « une tasse en céramique sur une table de café sous la pluie, lent travelling avant, lumière chaude de fenêtre » précise le sujet, le lieu, l’atmosphère et la direction de caméra. Les consignes précises réduisent l’ambiguïté, sans garantir un résultat parfait au premier essai. La génération est itérative : on évalue, on précise le prompt ou la référence, puis on crée une nouvelle version.
Le rôle des modèles de diffusion
De nombreux systèmes modernes de texte en vidéo utilisent la diffusion. Ils partent de bruit visuel et le retirent progressivement tout en suivant le prompt. Au fil des étapes de débruitage, couleurs, objets, éclairage et mouvement deviennent un clip cohérent.
Contrairement à l’animation image par image, le modèle doit raisonner sur le clip comme une séquence. Il doit préserver l’apparence du sujet tout en prédisant son prochain mouvement. Ce raisonnement temporel explique en grande partie la progression de la caméra et de l’action dans les vidéos IA actuelles.
Pourquoi le prompt influence le résultat
Les prompts sont des directions, pas des scripts de production. Le modèle peut inférer ce qui manque, mais pas toujours comme le souhaite le créateur. Un prompt solide décrit généralement :
- Le sujet principal et les références visuelles essentielles
- L’action et sa vitesse
- Le décor, le moment de la journée et l’éclairage
- Le cadrage ou le mouvement de caméra
- Le style et le format souhaités
Commencez par le moment narratif le plus important et n’ajoutez des détails que lorsqu’ils renforcent le contrôle. Une longue liste d’adjectifs sans lien peut rendre le résultat moins prévisible.
Pourquoi la cohérence du mouvement est difficile
Chaque image vidéo doit se relier à la précédente. Si un visage change, si un vêtement change de couleur ou si un objet se déplace sans raison, le public le remarque. Ces défauts sont appelés incohérence temporelle ou dérive visuelle.
Le mouvement doit aussi avoir une logique crédible. Lorsqu’une personne se tourne, corps, vêtement, ombres et perspective doivent évoluer ensemble. Les longues séquences, les scènes chargées, les mouvements de caméra rapides et les interactions détaillées demandent encore une direction et une vérification soigneuses.
Réduire la dérive en pratique
- Utilisez une référence de personnage ou de produit lorsque l’identité compte.
- Gardez sujet, tenue, environnement et lumière stables entre les plans liés.
- Générez un plan clair à la fois, puis montez avec les plans approuvés.
- Ne changez pas simultanément style, langage optique et description du sujet.
- Vérifiez à vitesse normale : une image fixe peut cacher un défaut de mouvement.
Avec le générateur vidéo IA PixVerse, les flux texte en vidéo et image en vidéo offrent des points de départ différents. Le texte convient à l’exploration ; une référence d’image est souvent préférable lorsqu’un produit, personnage ou style doit rester reconnaissable.
Quel outil vidéo IA convient à votre projet ?
| Flux | Idéal pour | Compromis principal |
|---|---|---|
| Génération cinématographique | Films de marque, courts créatifs, concepts visuels | Davantage de travail de prompt et de direction |
| Vidéo avec avatar | Formation, explication, présentateur | Moins de liberté narrative visuelle |
| Production par modèles | Contenu social ou de campagne répétable | Personnalisation plus limitée |
Les flux cinématographiques privilégient cadrage, ambiance et mouvement. Les avatars conviennent lorsqu’un présentateur porte le message. Les modèles sont efficaces lorsque la structure est connue et que l’équipe a besoin de variantes. Chaque scène doit avoir un objectif clair.
Un flux de production simple
- Définissez audience, message, durée et format de livraison.
- Découpez le concept en temps visuels plutôt qu’en une longue description.
- Choisissez texte en vidéo pour explorer, image en vidéo pour la continuité.
- Générez et approuvez chaque plan clé avant de continuer.
- Assemblez les meilleurs plans, puis ajoutez son, titres, sous-titres et revue finale.
Cette méthode convient à un créateur seul comme à une équipe qui bâtit une chaîne de contenu réutilisable. Elle sépare les choix créatifs de l’itération technique et rend les retours concrets.
Ce qu’il faut attendre de la vidéo IA aujourd’hui
La vidéo IA accélère l’expérimentation visuelle, sans supprimer le jugement éditorial. Les résultats les plus solides ont un sujet clair, une action focalisée et des coupes délibérées. Les récits complexes, les détails produits exacts et l’action continue longue bénéficient de références, de planification et de davantage de revue.
La question utile n’est pas de savoir si l’IA remplace toute la production, mais où elle aide à transformer plus vite une idée en direction visuelle testable.
FAQ
Quelle est la technologie centrale de la génération vidéo par IA ?
Les systèmes modernes emploient souvent des modèles de diffusion qui affinent du bruit en images guidées par un texte, une image ou une référence vidéo, tout en modélisant leurs liens dans le temps.
Pourquoi certaines vidéos IA paraissent-elles incohérentes ?
Le modèle doit préserver identité, décor, lumière et mouvement sur de nombreuses images. Des prompts ambigus, de longues scènes sans coupe et l’absence de références compliquent ce travail.
Texte en vidéo ou image en vidéo : quel choix ?
Le texte en vidéo est un bon point de départ pour de nouveaux concepts. L’image en vidéo est souvent plus utile lorsque l’identité visuelle d’une personne, d’un produit ou d’un lieu doit rester reconnaissable.
Conclusion
La génération vidéo par IA combine compréhension du langage, synthèse visuelle et prédiction temporelle pour transformer une idée en mouvement. Une direction claire, une planification de plans sensée et un flux itératif donnent de meilleurs résultats. Commencez par une scène ciblée et développez-la.
Guides associés
Poursuivez avec nos guides sur la vidéo à partir d’un script, la vidéo IA avec audio, la vidéo IA longue durée et la vidéo IA pour courts-métrages. Pour le contexte technique, consultez la synthèse sur les modèles de diffusion vidéo et la documentation Diffusers de Hugging Face.