AI動画生成の仕組み:実践ガイド
AI動画生成がテキストや画像を動きへ変える仕組みを、拡散モデル、時間的一貫性、適切なワークフローの選び方とともに解説します。
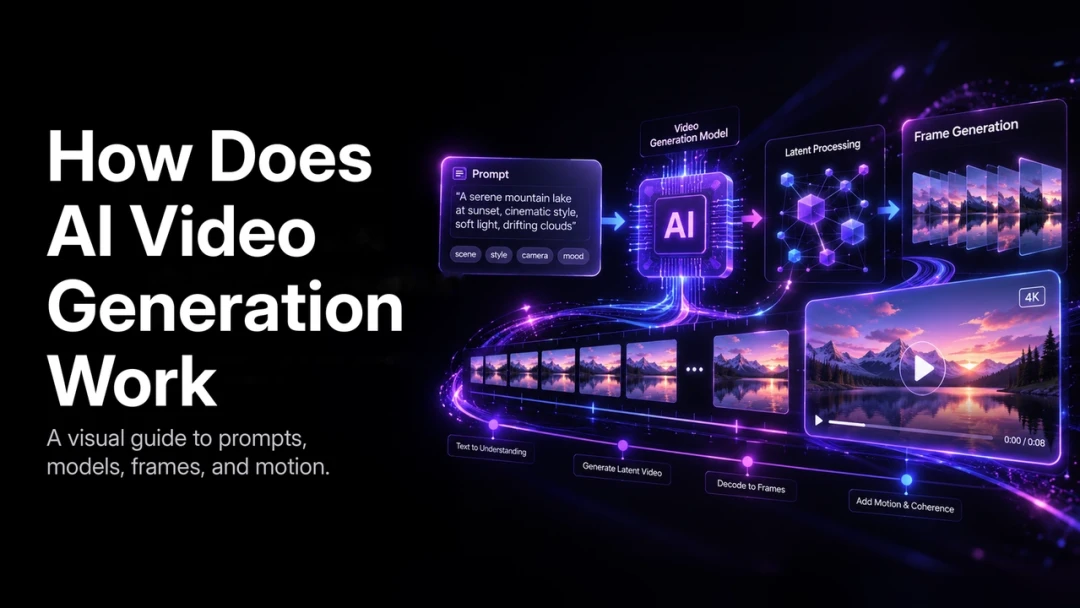
はじめに
AI動画生成は、文章によるアイデア、画像、短い参照クリップを動く映像コンテンツへ変換します。制作者はすべてのフレームを手作業でアニメーション化する代わりに、シーンを説明し、被写体、構図、動き、雰囲気へモデルを導きます。結果は、素早いコンセプト、ソーシャル動画、製品ビジュアル、または長い物語の一部になり得ます。
この技術は強力ですが、魔法ではありません。実用的なワークフローは、モデルがプロンプトをどう解釈するか、なぜフレーム間で動きがずれるのか、そしてどの種類のツールが目的に合うのかを理解することから始まります。本記事では基本を説明し、実際の制作に生かす方法を紹介します。
AI動画生成がアイデアを動きに変える仕組み
AI動画モデルは、言語、見た目、時間という三種類の情報を結び付けます。テキストプロンプトが意図を伝え、参照画像やクリップが視覚的な細部を定めます。次にモデルは、被写体とアクションが連続して見えるフレーム列を予測します。
たとえば「雨の日のカフェテーブルにある陶器のマグカップ、ゆっくりした寄り、暖かい窓の光」というプロンプトには、被写体、場所、雰囲気、カメラ方向が含まれます。具体的な指示は曖昧さを減らしますが、最初の出力が完璧になるとは限りません。生成は反復的です。結果を評価し、プロンプトや参照を明確にして次の版を作ります。
拡散モデルの役割
多くの現代的なテキストから動画へのシステムは拡散を利用します。視覚的なノイズから始め、プロンプトに従いながら徐々にノイズを取り除きます。何度もノイズ除去を繰り返す中で、色、物体、照明、動きがまとまりのあるクリップへ形作られます。
従来のフレーム単位のアニメーションと違い、動画モデルはクリップ全体を連続したものとして推論する必要があります。被写体の見た目を保ちながら、次にどこへ動くかも予測します。この時間的推論が、現在のAI動画でより説得力のあるカメラワークや動きを実現する大きな理由です。
プロンプトが結果に影響する理由
プロンプトは制作台本ではなく、方向を示すものです。モデルは不足した情報を推測できますが、その推測が意図と異なることもあります。優れたプロンプトには通常、次の内容が含まれます。
- 主な被写体と重要な視覚参照
- アクションとその速度
- 場所、時間帯、照明
- カメラの構図または動き
- 希望するスタイルとアスペクト比
最も重要な物語の瞬間から始め、制御を高める場合にだけ詳細を加えましょう。関係のない形容詞を長く並べると、具体性が増すのではなく、結果が予測しにくくなることがあります。
動きの一貫性が難しい理由
動画の各フレームは前のフレームとつながっていなければなりません。顔の形が変わる、衣装の色が変わる、物体が理由なく移動すると、視聴者はすぐに気付きます。こうした問題は一般に時間的一貫性の欠如、または視覚的ドリフトと呼ばれます。
動きには納得できる因果関係も必要です。人物が向きを変える際には、身体、衣服、影、カメラの遠近感が一緒に変化するべきです。モデルは改善されていますが、長いシーケンス、混雑したシーン、速いカメラ移動、複雑な相互作用には、丁寧な演出と確認が必要です。
ドリフトを減らす実践的な方法
制作者は、書き出し後に修正しようとするより、生成前に一貫性を高めることができます。
- アイデンティティが重要な場合は、人物または製品の参照を使用します。
- 関連するショット間で、被写体、衣装、環境、照明を安定させます。
- 一度に一つの明確なショットを生成し、承認済みのショットで編集を組みます。
- スタイル、レンズ表現、被写体の説明を同時に変更しません。
- 通常の再生速度で確認します。静止画では動きの問題が隠れることがあります。
PixVerse では、テキストから動画と画像から動画のワークフローが異なる出発点を提供します。自由な発想にはテキストが有用で、特定の製品、キャラクター、見た目をシーン全体で保ちたい場合は画像参照が適しています。
プロジェクトに合うAI動画ツールの種類
AI動画ツールには主に三つの用途があります。正しい選択は、最も目を引くデモではなく、必要な出力によって決まります。
| ワークフロー | 向いている用途 | 主なトレードオフ |
|---|---|---|
| シネマティック生成 | ブランド映像、創作短編、ビジュアルコンセプト | プロンプトとショット演出により多くの作業が必要 |
| アバター主体の動画 | 研修、解説、プレゼンター形式 | 視覚的な物語表現の自由度が低い |
| テンプレート主体の制作 | 繰り返し作るSNS・キャンペーンコンテンツ | カスタマイズに制限がある |
シネマティックなワークフローは構図、雰囲気、動きを優先します。アバター型は、話す人物がメッセージを運ぶ内容に適しています。テンプレートは、構造が決まっていて多数のバリエーションが必要な場合に効率的です。一つのプロジェクトで組み合わせることもできますが、各シーンには明確な目的が必要です。
シンプルな制作ワークフロー
AI動画を最も確実に使う方法は、短い制作サイクルとして扱うことです。
- 視聴者、メッセージ、長さ、納品形式を定義します。
- 一つの長い説明ではなく、コンセプトをいくつかの視覚的なビートに分けます。
- 探索にはテキストから動画、視覚的な連続性には画像から動画を選びます。
- 次へ進む前に、各キ―ショットを生成して承認します。
- 最も良いショットを組み、音、タイトル、字幕、最終確認を加えます。
この方法は、コンセプトを試す個人制作者にも、再利用可能なコンテンツパイプラインを作るチームにも役立ちます。創造的な判断と技術的な反復を分けるため、カメラの高さを変える、キャラクター参照を保つ、アクションを遅くするといった具体的なフィードバックが可能です。
現在のAI動画に期待できること
AI動画は視覚的な試作を速くしますが、編集上の判断を不要にはしません。良い結果には、明確な被写体、焦点を絞った動き、意図的なシーンの切り替えがあります。複雑な複数人物の物語、正確な製品の細部、長く連続するアクションには、参照、ショット計画、より多くの確認時間が必要です。
重要なのは、AIがすべての制作作業を置き換えられるかではなく、どこでアイデアを検証可能な映像方向へ速く移せるかです。良いプロンプト、一貫した参照、規律ある確認プロセスがあれば、AI動画は実用的な制作工程の一部になります。
よくある質問
AI動画生成の中核技術は何ですか?
現代のシステムは一般に、テキストプロンプト、画像、動画参照に導かれながら、ノイズをフレームへ洗練していく拡散ベースのモデルを用います。また、それらのフレームが時間の中でどう関係するかもモデル化します。
AI動画が不自然になったり一貫しなかったりするのはなぜですか?
モデルは多くのフレームにわたり、アイデンティティ、場所、照明、動きを保つ必要があります。曖昧なプロンプト、長く切れ目のないシーン、参照の不足はこの作業を難しくします。
テキストから動画と画像から動画はどちらが良いですか?
新しいコンセプトの出発点としてはテキストから動画が有効です。人物、製品、場所の視覚的アイデンティティを認識できる状態で保ちたい場合は、画像から動画がより有用です。
まとめ
AI動画生成は、言語理解、視覚合成、時間的予測を組み合わせ、アイデアを動きに変えます。明確な方向性、適切なショット計画、反復的なワークフローがより良い成果につながります。まず一つの焦点を絞ったシーンから始め、モデルの反応を学びながら広げていきましょう。
関連ガイド
仕組みを制作に応用するには、スクリプトから動画を作る方法、音声付きAI動画、長編AI動画、短編映画向けAI動画もご覧ください。