PixVerse présente R2, vers des mondes persistants et jouables en temps réel
R2 fait évoluer le modèle de monde en temps réel de PixVerse pour traiter plus de données, de tâches et de types d'entrées tout en fonctionnant en temps réel.
La génération vidéo par IA à l’aide de modèles fondamentaux s’effectue généralement en une seule fois. Un modèle reçoit un prompt, génère un clip fixe, puis s’arrête. Pour apporter des modifications, l’utilisateur doit recommencer avec un nouveau prompt et un nouveau clip. Chaque résultat est clos et distinct.
Un modèle de monde en temps réel fonctionne différemment. Au lieu de renvoyer un clip, il génère un monde qui continue de fonctionner tant qu’un utilisateur s’y trouve. Le monde est navigable en temps réel. De nouvelles entrées arrivent pendant que le modèle génère encore et modifient la suite des événements. Le monde ne se réinitialise pas entre les actions et conserve son état pendant toute la session, en restant cohérent à mesure que celle-ci se prolonge.
En janvier 2026, PixVerse a présenté R1, le premier modèle de monde en temps réel au monde. R1 a démontré que ce paradigme était viable : la vidéo pouvait devenir un flux audiovisuel continu et interactif plutôt qu’une sortie figée.
Aujourd’hui, nous lançons R2, une évolution du modèle de monde en temps réel. Il reste cohérent sur des sessions bien plus longues, se souvient de ce qui se produit dans une session et le prolonge, tout en intégrant texte, références, audio et commandes d’action dans le même monde en cours d’exécution.
Un monde qui se souvient et qui répond
Le changement essentiel de R2 concerne ce que les entrées peuvent accomplir. Dans la vidéo IA classique comme dans les versions antérieures de la génération en temps réel, une entrée affecte le moment présent, puis ce moment passe. L’action suivante repart à zéro. Le monde ne conserve rien.
Dans R2, les entrées persistent. Un prompt, une action ou un signal audio ne modifie pas seulement l’image actuelle. Il met à jour l’état actif du monde et façonne la suite : le comportement ultérieur d’un personnage, le dénouement d’une situation et l’évolution de l’environnement au fil de la session. Une action antérieure reste vraie plus tard dans la même session.
Explorez un monde vivant. Un joueur entre dans un monde généré et s’y déplace en temps réel, en contrôlant un personnage avec les touches WASD et en orientant la caméra avec les touches fléchées. Les prompts modifient le monde au fil du jeu, ajoutant des éléments et transformant l’environnement. Le personnage interagit avec ce qui l’entoure selon une logique physique, et chaque entrée s’appuie sur la précédente au lieu de repartir de zéro.
Façonnez l’histoire. Le monde peut développer une narration qui s’adapte aux actions du joueur. Dans Zero Mark, un jeu-film interactif créé sur R2 par le créateur Xiaolongbao, une créature bloque le chemin et demande un cadeau. Lui offrir un dragon ou une feuille entraîne des réactions réellement différentes. L’histoire se ramifie à partir de l’entrée au lieu de suivre un parcours préécrit, et le modèle génère chaque résultat en direct.
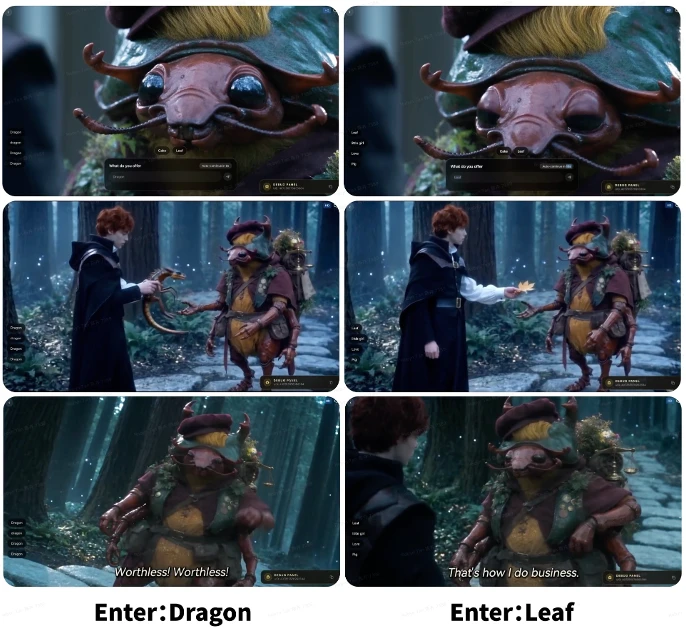
Dans Zero Mark, la même rencontre suit deux chemins : offrir à la créature un dragon ou une feuille produit des réactions différentes, générées en direct.
Des personnages qui répondent au contexte. Les personnages du monde peuvent comprendre le joueur et répondre en accord avec l’histoire. Dans un récit interactif conçu par la créatrice Jade Wu sur R2, les joueurs parlent avec un personnage nommé Eve, qui conserve son identité et sa mémoire tout au long de la conversation, fait émerger des indices et fait avancer l’intrigue. Ses réponses, ses expressions et ses mouvements suivent à la fois la conversation en cours et l’étape atteinte par l’histoire. Elle maintient une identité cohérente durant de nombreux échanges au lieu de se réinitialiser, et ressemble moins à un personnage non-joueur scénarisé qu’à quelqu’un qui vous connaît et suit ce qui se passe.
Le défi du passage à l’échelle et la réponse de R2
À la différence de la génération d’un clip vidéo fixe, où le modèle reçoit un seul prompt et une durée définie à remplir, un monde qui continue de fonctionner n’a pas cette limite. Il doit accomplir plusieurs tâches simultanément, en continu et sans rupture :
- Rester cohérent dans le temps. Le personnage, le lieu et les règles du monde doivent rester les mêmes. Chaque seconde supplémentaire d’exécution est une occasion supplémentaire de dériver.
- Accepter des entrées en cours de génération. Le modèle ne peut pas s’arrêter pour réfléchir. De nouvelles commandes arrivent alors que le monde est en mouvement et doivent être intégrées sans l’interrompre.
- Se souvenir et se rétablir. Le modèle doit conserver ce qui s’est déjà produit et, lorsque de petites erreurs s’accumulent au cours d’une longue session, les corriger plutôt que les amplifier.
- Faire tout cela en direct. Le budget de latence doit rester suffisamment faible pour que l’expérience soit interactive.
Derrière ces exigences se trouve une tension plus profonde. La façon habituelle de rendre un modèle assez rapide pour le temps réel consiste à le simplifier, et la façon habituelle de le rendre plus capable consiste à le rendre plus lourd et plus lent. Vitesse et capacité tirent dans des directions opposées. L’approche standard utilisée dans le secteur pour construire ces systèmes aggrave le problème : une longue chaîne d’étapes d’entraînement distinctes, chacune passant le relais à la suivante, avec une qualité et une stabilité qui s’érodent à chaque transition.
La réponse de R2 consiste à ne plus imposer un choix entre vitesse et capacité, et à répartir le travail en deux étapes bâties sur la même fondation. Omni Causal AR est le moteur de capacité, agissant comme une colonne vertébrale entraînée en continu. Il développe un modèle causal unique qui continue d’apprendre à partir de davantage de données, de types d’entrées, de tâches et de périodes de temps plus longues, en accumulant la capacité au même endroit au lieu de la dégrader lors des transmissions.
La couche d’accélération en temps réel reprend ensuite ce même modèle et le compresse pour une exécution en direct, au lieu d’entraîner de zéro un modèle rapide séparé. Les gains de capacité ne se font donc plus au détriment de la vitesse.
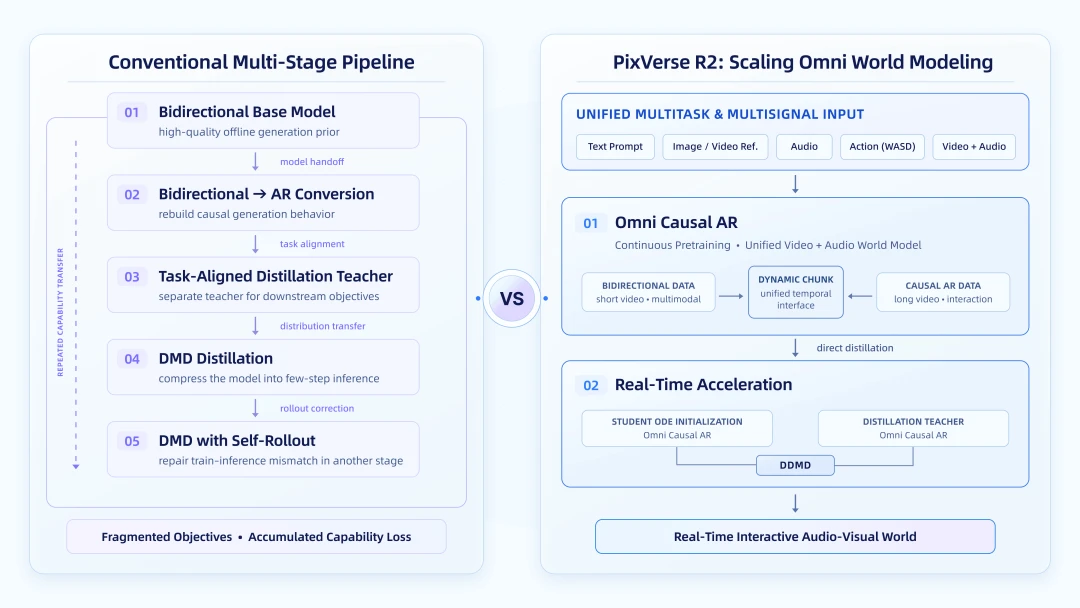
Comment R2 remplace le pipeline d’entraînement conventionnel en plusieurs étapes, où la qualité se dégrade à chaque passage, par un modèle unique entraîné en continu et compressé pour le temps réel.
Autour de ces deux étapes se trouve un ensemble de choix d’ingénierie ciblés qui permettent à chaque gain de capacité d’atteindre le produit en temps réel. Le rapport technique complet de PixVerse R2 présente l’architecture et les détails de l’évaluation.
“Les grands modèles de langage ont montré que le passage à l’échelle est une voie fiable vers la capacité”, a déclaré Changhu Wang, cofondateur et CEO de PixVerse. “R2 montre que les modèles de monde en temps réel peuvent suivre une voie similaire : avec la bonne architecture, un modèle peut gagner continuellement en capacité sans renoncer à l’interaction en temps réel. Avec le temps, c’est ainsi qu’un outil de création devient un environnement dans lequel les gens peuvent entrer et donner forme à leurs idées.”
Du modèle de monde aux jeux jouables
R2 est passé d’une démonstration de recherche à une technologie sur laquelle de véritables produits peuvent être construits. Lancé en juillet 2026, le PixVerse Game Engine fonctionne désormais avec R2.
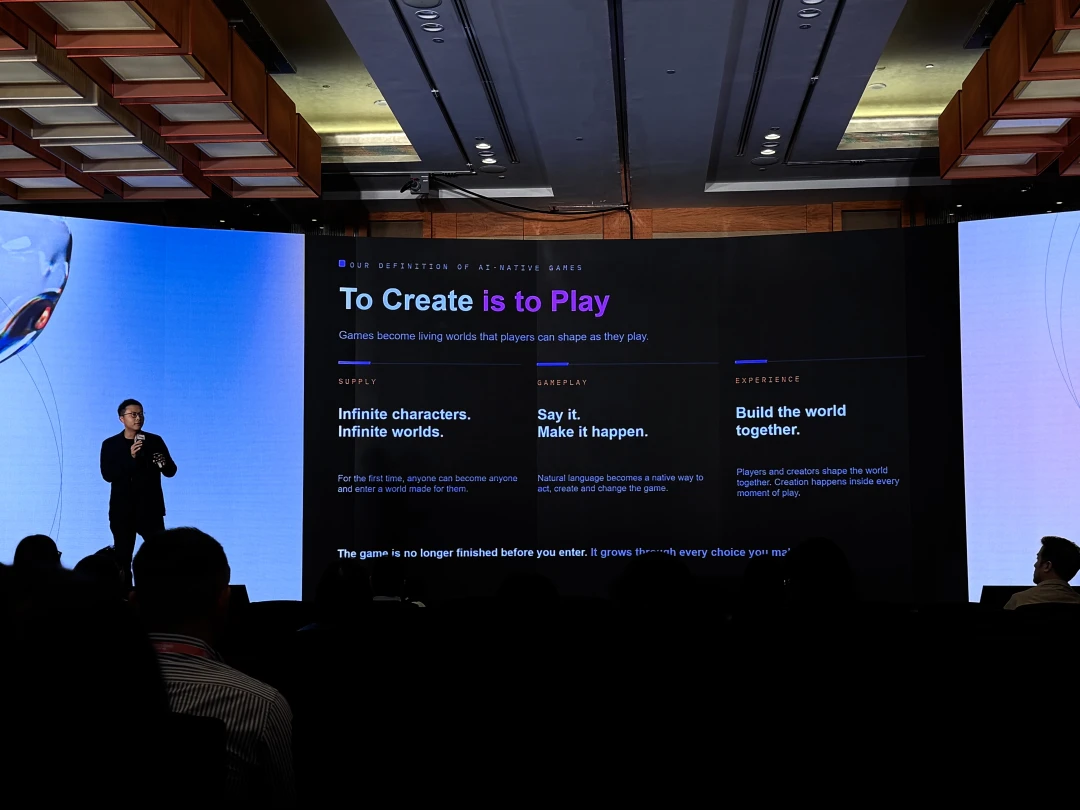
Chow Li, Head of PixVerse Games, présente le moteur de jeu en temps réel de PixVerse lors de la Tech in Asia Conference en septembre 2026.
Lors de sa présentation à la Tech in Asia Conference en septembre, Chow Li, Head of Games chez PixVerse, a décrit ce changement comme une nouvelle définition de ce qu’un jeu peut être. Les éléments qui font traditionnellement un jeu — personnages, mondes et choix du joueur — cessent d’être des ressources fixes créées à l’avance. Un joueur peut désormais dire ce qu’il souhaite et le voir se produire ; l’expérience prend forme dans le jeu au lieu d’être écrite en amont. Créer le monde et y jouer deviennent le même geste.
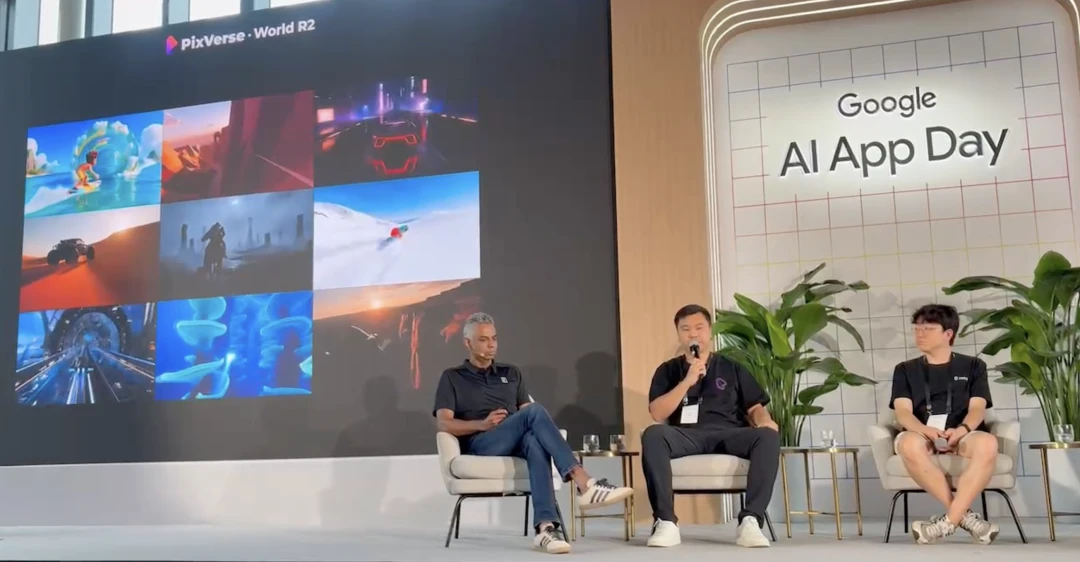
Jaden Xie, cofondateur et président de PixVerse, intervient lors d’une table ronde au Google AI App Day à Singapour en septembre 2026.
Lors d’une table ronde au Google AI App Day à Singapour, le cofondateur et président Jaden Xie a présenté les avancées des modèles vidéo comme un puissant moteur de la prochaine vague de jeux natifs de l’IA. “Ce qui nous enthousiasme, c’est ce que les créateurs construisent sur notre modèle de monde depuis l’ouverture de la bêta en juillet”, a déclaré Jaden. “Nous pensons que nos modèles vidéo permettront à davantage de créateurs de donner vie à leurs idées.”
Disponibilité
Une collection de ces mondes est maintenant ouverte à l’exploration sur world.pixverse.video.
À propos de PixVerse
PixVerse est une plateforme mondiale de génération vidéo par IA à laquelle font confiance plus de 150 millions d’utilisateurs dans plus de 177 pays. Avec une suite de modèles propriétaires développés entièrement en interne, PixVerse permet à chacun de créer des vidéos de qualité cinématographique à partir d’un prompt, d’une photo ou d’un clip. En janvier 2026, PixVerse a lancé R1, le premier modèle de monde en temps réel au monde, transformant la vidéo en un flux infini, continu et interactif. R2 s’appuie sur cette fondation et fait évoluer le modèle de monde en temps réel pour exécuter des sessions plus longues et plus cohérentes. Avec des équipes réparties en Asie et aux États-Unis, PixVerse a été fondée en 2023 avec la volonté de faire de la vidéo le langage universel de l’expression humaine. En mars 2026, PixVerse a clôturé son tour de série C et atteint le statut de licorne. Pour plus d’informations, rendez-vous sur pixverse.ai.