Wie funktioniert KI-Videogenerierung? Ein Praxisleitfaden
Erfahren Sie, wie KI Text und Bilder in Bewegung verwandelt, welche Rolle Diffusionsmodelle spielen und wie Sie den passenden Video-Workflow wählen.
Einführung
KI-Videogenerierung verwandelt eine schriftliche Idee, ein Bild oder einen kurzen Referenzclip in bewegte visuelle Inhalte. Statt jedes Einzelbild von Hand zu animieren, beschreiben Kreative eine Szene und leiten das Modell zu Motiv, Komposition, Bewegung und Stimmung. Das Ergebnis kann ein schneller Entwurf, ein Social Clip, ein Produktvisual oder Teil einer längeren Geschichte sein.
Die Technologie ist leistungsfähig, aber nicht magisch. Ein hilfreicher Workflow beginnt damit, zu verstehen, wie ein Modell Prompts liest, warum Bewegung zwischen Bildern abweichen kann und welches Werkzeug zum Projekt passt.
Wie KI Ideen in Bewegung umsetzt
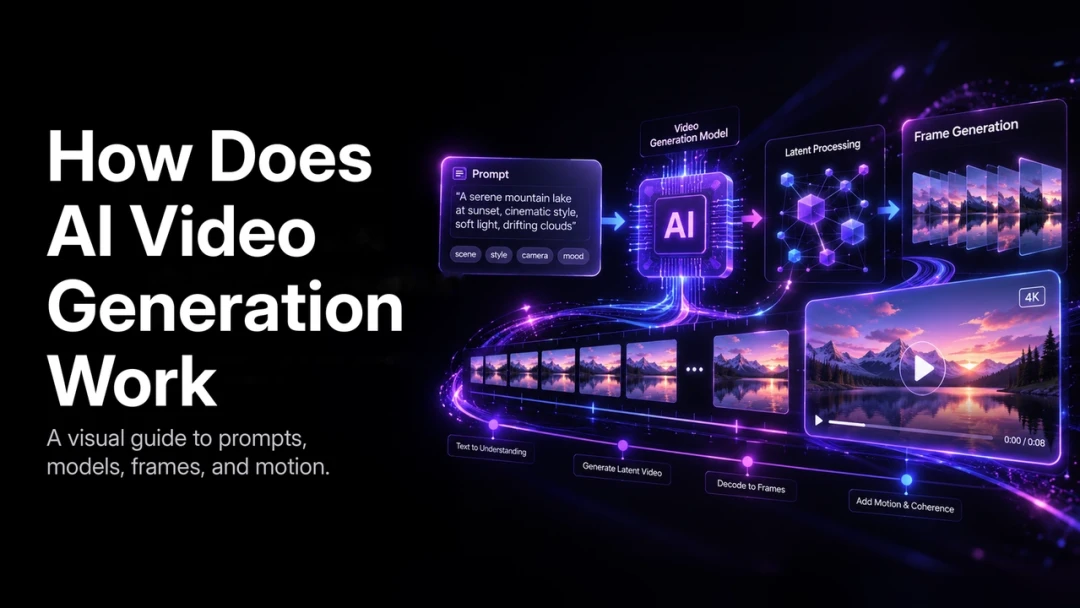
Ein KI-Videomodell verbindet Sprache, Erscheinungsbild und Zeit. Der Textprompt vermittelt die Absicht; Referenzbilder oder Clips können visuelle Details festlegen; anschließend sagt das Modell eine Folge von Einzelbildern voraus, in der Motiv und Aktion kontinuierlich wirken.
Ein Prompt wie „eine Keramiktasse auf einem Café-Tisch im Regen, langsame Kamerafahrt nach vorn, warmes Fensterlicht“ beschreibt Motiv, Ort, Atmosphäre und Kamerarichtung. Konkrete Angaben verringern Mehrdeutigkeit, garantieren aber kein perfektes erstes Ergebnis. Die Arbeit ist iterativ: Ergebnis prüfen, Prompt oder Referenz präzisieren und die nächste Version erzeugen.
Die Rolle von Diffusionsmodellen
Viele moderne Text-zu-Video-Systeme nutzen Diffusion. Sie beginnen mit visuellem Rauschen und entfernen es schrittweise, während sie dem Prompt folgen. Über mehrere Verfeinerungsschritte entstehen Farbe, Objekte, Licht und Bewegung als zusammenhängender Clip.
Anders als bei bildweiser Animation muss das Modell den Clip als Sequenz verstehen. Es muss das Aussehen des Motivs bewahren und gleichzeitig dessen nächste Bewegung vorhersagen. Dieses zeitliche Schlussfolgern ist ein wichtiger Grund für überzeugendere Kamerabewegungen und Aktionen heutiger KI-Videos.
Warum Prompts das Ergebnis beeinflussen
Prompts sind Anweisungen, keine Produktionsdrehbücher. Ein Modell kann fehlende Details erschließen, aber anders als beabsichtigt. Starke Prompts enthalten meist:
- Hauptmotiv und wichtige Bildreferenzen
- Aktion und Geschwindigkeit
- Umgebung, Tageszeit und Licht
- Kamerabild oder Kamerabewegung
- Gewünschten Stil und Bildformat
Beginnen Sie mit dem wichtigsten erzählerischen Moment und ergänzen Sie Details nur, wenn sie mehr Kontrolle schaffen. Eine lange Liste unverbundener Adjektive macht Ergebnisse oft weniger vorhersehbar.
Warum Bewegungskonsistenz schwierig ist
Jedes Bild muss mit dem vorherigen verbunden sein. Wenn sich ein Gesicht, eine Kleidungsfarbe oder die Position eines Objekts ohne Grund ändert, fällt es Zuschauenden sofort auf. Man spricht dann von zeitlicher Inkonsistenz oder visuellem Drift.
Bewegung benötigt zudem glaubwürdige Ursache und Wirkung. Dreht sich eine Person, sollten Körper, Kleidung, Schatten und Kameraperspektive gemeinsam reagieren. Lange Sequenzen, volle Szenen, schnelle Kamerabewegungen und komplexe Interaktionen brauchen weiterhin sorgfältige Regie und Prüfung.
Praktische Wege gegen Drift
- Nutzen Sie eine Charakter- oder Produktreferenz, wenn Identität wichtig ist.
- Halten Sie Motiv, Garderobe, Umgebung und Licht zwischen verbundenen Einstellungen stabil.
- Erzeugen Sie eine klare Einstellung nach der anderen und schneiden Sie mit freigegebenen Ergebnissen.
- Ändern Sie Stil, Objektivsprache und Motivbeschreibung nicht gleichzeitig.
- Prüfen Sie bei normaler Wiedergabegeschwindigkeit; Standbilder können Bewegungsfehler verbergen.
Mit dem PixVerse KI-Videogenerator bieten Text-zu-Video und Bild-zu-Video unterschiedliche Ausgangspunkte. Text eignet sich für offene Ideen; eine Bildreferenz ist oft besser, wenn ein bestimmtes Produkt, ein Charakter oder Look erkennbar bleiben muss.
Welches KI-Video-Werkzeug passt zum Projekt?
| Workflow | Geeignet für | Wichtigster Kompromiss |
|---|---|---|
| Filmische Generierung | Markenfilme, kreative Kurzfilme, visuelle Konzepte | Mehr Prompt- und Einstellungsarbeit |
| Avatar-Video | Schulungen, Erklärungen, Presenter-Formate | Weniger visuelle Erzählfreiheit |
| Template-Produktion | Wiederholbare Social- und Kampagneninhalte | Begrenztere Anpassung |
Filmische Workflows priorisieren Bildgestaltung, Atmosphäre und Bewegung. Avatar-Workflows passen, wenn eine sprechende Person die Botschaft trägt. Templates sind effizient, wenn die Struktur feststeht und viele Varianten benötigt werden. Jede Szene sollte einen klaren Zweck haben.
Ein einfacher Produktionsablauf
- Zielgruppe, Botschaft, Länge und Ausgabeformat definieren.
- Das Konzept in visuelle Momente statt in eine lange Beschreibung gliedern.
- Text-zu-Video zum Erkunden, Bild-zu-Video für visuelle Kontinuität wählen.
- Jede Schlüsselaufnahme erzeugen und freigeben, bevor es weitergeht.
- Die besten Einstellungen zusammensetzen und Ton, Titel, Untertitel sowie Endprüfung ergänzen.
Dieser Ablauf hilft einzelnen Kreativen ebenso wie Teams mit wiederverwendbarer Content-Pipeline. Kreative Entscheidungen und technische Iteration werden getrennt, sodass Feedback konkret bleibt.
Was Sie von KI-Video heute erwarten können
KI-Video beschleunigt visuelle Experimente, ersetzt aber kein redaktionelles Urteil. Starke Ergebnisse haben ein klares Motiv, eine fokussierte Aktion und bewusste Schnitte. Komplexe Geschichten mit mehreren Figuren, exakte Produktdetails und lange ununterbrochene Aktionen profitieren von Referenzen, Shot-Planung und zusätzlicher Prüfung.
Die produktive Frage lautet nicht, ob KI jede Produktionsaufgabe ersetzt, sondern wo sie eine Idee schneller in eine prüfbare visuelle Richtung bringt.
FAQ
Was ist die Kerntechnologie hinter KI-Videogenerierung?
Moderne Systeme nutzen häufig diffusionsbasierte Modelle, die Rauschen unter Führung von Text, Bild oder Videoreferenz zu Bildern verfeinern und deren zeitliche Beziehung modellieren.
Warum wirken KI-Videos manchmal inkonsistent?
Das Modell muss Identität, Umgebung, Licht und Bewegung über viele Bilder hinweg bewahren. Mehrdeutige Prompts, lange ungeschnittene Szenen und fehlende Referenzen erschweren dies.
Ist Text-zu-Video oder Bild-zu-Video besser?
Text-zu-Video ist ein guter Start für neue Konzepte. Bild-zu-Video ist meist nützlicher, wenn die visuelle Identität einer Person, eines Produkts oder Ortes wiedererkennbar bleiben soll.
Fazit
KI-Videogenerierung verbindet Sprachverständnis, visuelle Synthese und zeitliche Vorhersage, um Ideen in Bewegung zu übersetzen. Klare Richtung, sinnvolle Shot-Planung und ein iterativer Workflow führen zu besseren Ergebnissen. Beginnen Sie mit einer fokussierten Szene und bauen Sie darauf auf.
Verwandte Leitfäden
Lesen Sie außerdem unsere Leitfäden zu Video aus einem Skript, KI-Video mit Audio, Langform-KI-Video und KI-Video für Kurzfilme. Technische Hintergründe finden Sie in der Übersicht zu Video-Diffusionsmodellen und in der Hugging-Face-Diffusers-Dokumentation.