AI 视频生成如何工作:实用指南
了解 AI 视频生成如何将文本和图像转化为动态画面,并掌握扩散模型、时序一致性与工作流选择的核心知识。
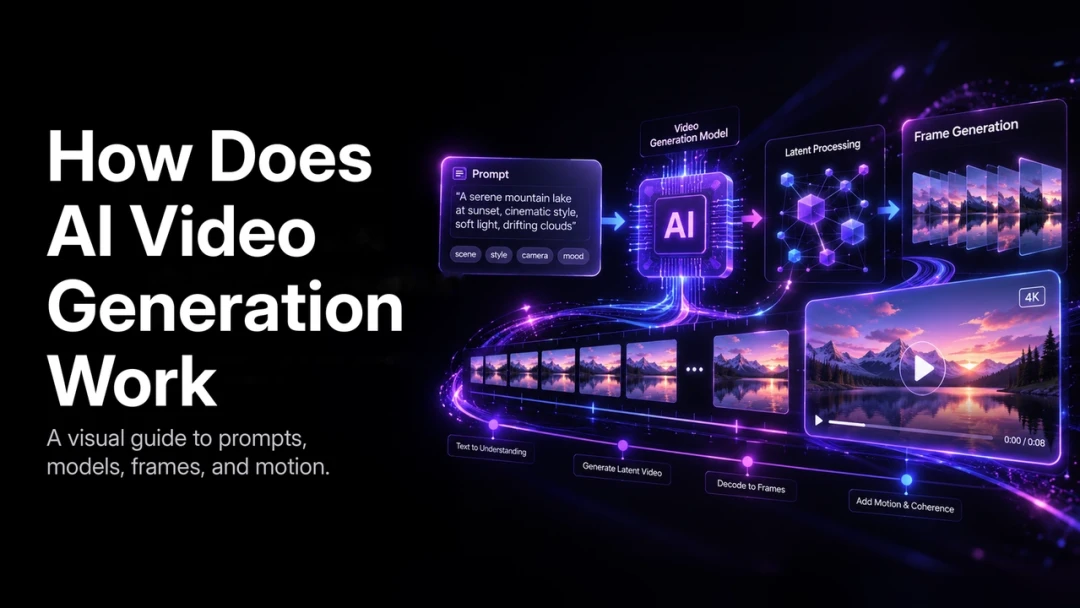
引言
AI 视频生成能够把文字创意、图像或短参考视频转化为动态视觉内容。创作者无需逐帧手工制作动画,而是描述场景,并引导模型理解主体、构图、运动和氛围。生成结果可以是快速概念稿、社交媒体短片、产品视觉内容,或更长叙事的一部分。
这项技术很强大,但并非魔法。实用的工作流始于理解模型如何解读提示词、为什么运动会在帧与帧之间产生漂移,以及哪类工具适合当前任务。本文将说明核心原理,并介绍如何将其用于实际创作。
AI 视频生成如何将创意转化为动态画面
AI 视频模型会连接语言、外观与时间三类信息。文本提示词传达创作意图,参考图像或视频片段可以确定视觉细节,随后模型预测一系列连续帧,使主体和动作看起来连贯。
例如,“雨天咖啡馆桌上的陶瓷杯,镜头缓慢推进,温暖的窗边光线”这样的提示词,同时给出了主体、环境、氛围和镜头方向。具体指令能够减少歧义,但并不能保证一次得到完美结果。生成本身是迭代过程:创作者评估结果,澄清提示词或参考素材,再生成下一版。
扩散模型的作用
许多现代文生视频系统使用扩散技术。它们从视觉噪声开始,在遵循提示词的同时逐步去除噪声。经过多轮去噪,系统会把颜色、物体、光线和运动塑造成连贯的视频片段。
与传统逐帧动画不同,视频模型必须把片段视为一个序列来推理。它既要记住主体的外观,也要预测其下一刻的位置。这种时序推理能力,是当前 AI 视频在镜头运动和动作表现上比早期系统更可信的重要原因。
为什么提示词会影响结果
提示词是方向,而不是完整的制作脚本。模型可以推断缺失的信息,但推断结果可能与创作者的设想不同。高质量提示词通常包含:
- 主要主体及重要视觉参考
- 动作及其速度
- 场景、时间和光线
- 镜头构图或运动方式
- 目标风格和画面比例
先从最关键的故事瞬间开始,仅在能提升控制力时再补充细节。一长串彼此无关的形容词往往会让结果更难预测,而不是更具体。
为什么运动一致性很难实现
视频中的每一帧都必须与前一帧相连。如果面部形状变化、服装颜色改变,或物体无故移位,观众会立刻察觉。这类问题通常被称为时序不一致或视觉漂移。
运动还需要有可信的因果关系。人物转身时,身体、衣物、阴影和镜头透视都应同步变化。模型在这些协调能力上已有进步,但较长片段、拥挤场景、快速镜头运动和复杂互动仍需要仔细的创作方向和审查。
减少漂移的实用方法
创作者应在生成前提高一致性,而不是只在导出后尝试修复。
- 当身份识别很重要时,使用角色或产品参考图。
- 在关联镜头之间保持主体、服装、环境和光线稳定。
- 一次生成一个清晰镜头,再用通过审核的镜头完成剪辑。
- 不要同时更改风格、镜头语言和主体描述。
- 以正常播放速度审看;静帧可能掩盖运动问题。
在 PixVerse 中,文生视频和图生视频提供了不同的起点。文本适合开放式构思;当特定产品、角色或视觉风格需要在整个镜头中保持一致时,图像参考通常更合适。
哪类 AI 视频工具适合你的项目?
AI 视频工具通常服务于三类主要场景。正确选择取决于所需输出,而不是最吸睛的演示效果。
| 工作流 | 更适合 | 主要取舍 |
|---|---|---|
| 电影感生成 | 品牌影片、创意短片、视觉概念 | 需要更多提示词和镜头方向工作 |
| 虚拟形象视频 | 培训、讲解、出镜内容 | 视觉叙事自由度较低 |
| 模板化制作 | 可重复的社交或营销内容 | 自定义空间较有限 |
电影感工作流优先考虑构图、氛围和运动。以虚拟形象为主的工作流适合由讲述者承载信息的内容。模板适合结构已确定、团队需要大量变体的场景。项目可以结合这些方式,但每个镜头都应有明确目的。
简单的制作工作流
最可靠的 AI 视频使用方式,是把它当作一个短周期制作流程。
- 明确受众、信息、时长和交付格式。
- 将概念拆分成几个视觉节奏点,而不是写成一段冗长描述。
- 探索创意时选择文生视频;需要视觉连续性时选择图生视频。
- 在进入下一步前,先生成并确认每个关键镜头。
- 组合最好的镜头,再加入声音、标题、字幕并完成最终审查。
这种方式适合测试概念的个人创作者,也适合搭建可复用内容流程的团队。它把创意决策与技术迭代分开,使反馈更具体:调整镜头高度、保留角色参考,或放慢动作速度。
当下使用 AI 视频应有的预期
AI 视频让视觉试验更快,但并不取代编辑判断。最强的结果往往具有清晰主体、聚焦动作和经过设计的场景切换。复杂的多角色故事、精确的产品细节和长时间连续动作,都需要参考素材、镜头规划和更多审查时间。
更有价值的问题不是 AI 是否能取代所有制作环节,而是它能在哪些环节帮助创作者更快地把想法变成可测试的视觉方向。有了好的提示词、一致的参考和严谨的审查流程,AI 视频就能成为实用的创作工具。
常见问题
AI 视频生成的核心技术是什么?
现代系统通常使用基于扩散的模型,在文本提示词、图像或视频参考的引导下,把噪声逐步细化为画面帧,并建模这些帧在时间上的关联。
为什么 AI 视频有时看起来不一致?
模型必须在许多帧中保持身份、场景、光线和运动。模糊提示词、过长且不断开的场景,以及缺少参考素材,都会让这项任务更困难。
文生视频和图生视频哪个更好?
文生视频适合探索新概念。需要让人物、产品或场景的视觉身份保持可识别时,图生视频通常更有用。
结语
AI 视频生成结合了语言理解、视觉合成和时序预测,将创意转化为动态画面。清晰的方向、合理的镜头规划和迭代式工作流会带来更好的结果。先从一个聚焦的场景开始,了解模型的响应方式,再逐步扩展。
延伸阅读
继续阅读从脚本生成视频、带音频的视频生成、长篇 AI 视频生成和短片 AI 视频生成,将原理应用到具体制作流程中。