Как работает генерация видео с ИИ: практическое руководство
Узнайте, как ИИ превращает текст и изображения в видео, как работают диффузионные модели и как выбрать подходящий рабочий процесс.
Введение
Генерация видео с ИИ превращает письменную идею, изображение или короткий референсный клип в движущийся визуальный контент. Вместо ручной анимации каждого кадра автор описывает сцену и направляет модель к нужному объекту, композиции, движению и настроению. Результатом может быть быстрый концепт, ролик для соцсетей, визуал продукта или часть более длинной истории.
Технология мощная, но не магическая. Практический процесс начинается с понимания того, как модель интерпретирует промпт, почему движение может дрейфовать между кадрами и какой тип инструмента подходит задаче.
Как ИИ превращает идеи в движение
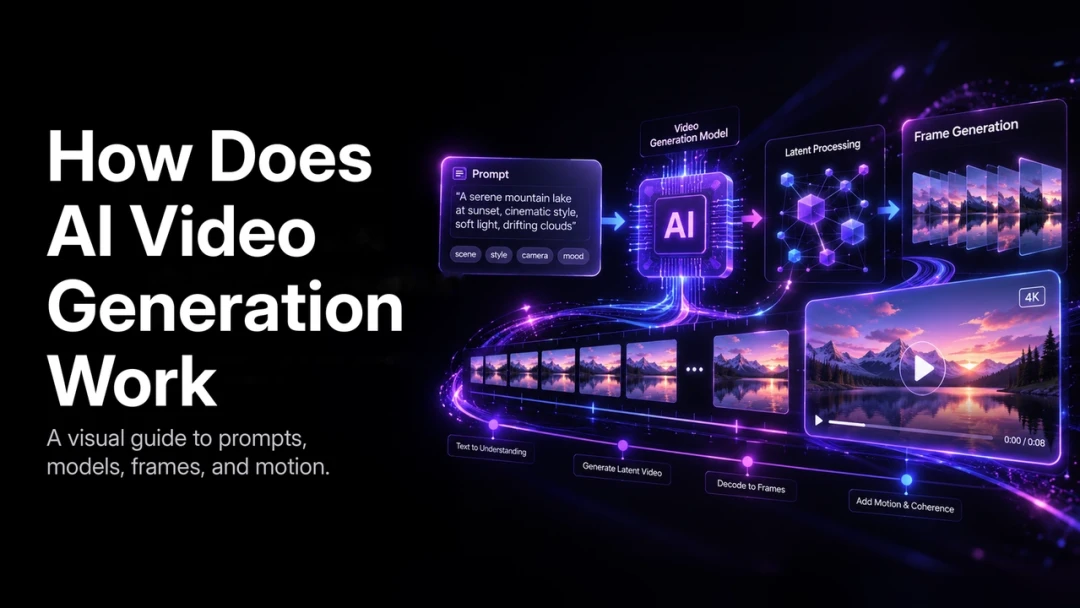
Модель ИИ-видео соединяет язык, внешний вид и время. Текстовый промпт передает намерение, референсные изображения или клипы задают визуальные детали, а затем модель предсказывает последовательность кадров, в которой объект и действие выглядят непрерывными.
Например, промпт «керамическая кружка на столике в дождливом кафе, медленный наезд камеры, теплый свет из окна» задает объект, место, атмосферу и камеру. Конкретика уменьшает неоднозначность, но не гарантирует идеальный первый результат. Генерация итеративна: результат оценивают, уточняют промпт или референс и создают следующую версию.
Роль диффузионных моделей
Многие современные системы «текст в видео» используют диффузию. Они начинают с визуального шума и постепенно очищают его, следуя промпту. Через повторные шаги денойзинга цвет, объекты, свет и движение формируют связный клип.
В отличие от покадровой анимации, видеомодель должна рассуждать о клипе как о последовательности. Ей нужно сохранять внешний вид объекта и одновременно предсказывать, куда он движется дальше. Такое временное рассуждение существенно улучшает движение и работу камеры в современных ИИ-видео.
Почему промпт влияет на результат
Промпт — это направление, а не полный производственный сценарий. Модель может вывести недостающие детали, но не всегда так, как задумал автор. Сильный промпт обычно описывает:
- Главный объект и важные визуальные референсы
- Действие и его скорость
- Окружение, время суток и освещение
- Кадрирование или движение камеры
- Нужный стиль и соотношение сторон
Начинайте с самого важного сюжетного момента и добавляйте детали только тогда, когда они усиливают контроль. Длинный список несвязанных прилагательных часто делает результат менее предсказуемым.
Почему трудно сохранить согласованность движения
Каждый кадр должен быть связан с предыдущим. Если меняется форма лица, цвет одежды или положение предмета без причины, зритель это замечает. Такие проблемы называют временной несогласованностью или визуальным дрейфом.
Движение также должно иметь правдоподобные причины и последствия. Когда человек поворачивается, тело, одежда, тени и перспектива камеры должны меняться вместе. Длинные последовательности, насыщенные сцены, быстрые движения камеры и сложные взаимодействия по-прежнему требуют тщательной режиссуры и проверки.
Практические способы уменьшить дрейф
- Используйте референс персонажа или продукта, если важна идентичность.
- Сохраняйте объект, одежду, окружение и свет стабильными в связанных кадрах.
- Генерируйте по одному понятному плану и монтируйте из одобренных кадров.
- Не меняйте одновременно стиль, оптический язык и описание объекта.
- Проверяйте на обычной скорости: стоп-кадр может скрыть ошибку движения.
В PixVerse рабочие процессы «текст в видео» и «изображение в видео» дают разные точки входа. Текст полезен для свободного поиска идей, а изображение — когда продукт, персонаж или визуальный образ должен оставаться узнаваемым.
Какой тип ИИ-видеоинструмента подходит проекту?
| Рабочий процесс | Лучше всего подходит для | Главный компромисс |
|---|---|---|
| Кинематографическая генерация | Бренд-фильмы, творческие короткометражки, визуальные концепты | Требует больше работы с промптами и постановкой |
| Видео с аватаром | Обучение, объяснения, формат ведущего | Меньше свободы визуального повествования |
| Шаблонное производство | Повторяемый социальный и кампанийный контент | Ограниченная кастомизация |
Кинематографические процессы делают акцент на кадре, атмосфере и движении. Аватары полезны, когда сообщение несет говорящий ведущий. Шаблоны эффективны, если структура уже известна и нужно много вариантов. У каждой сцены должна быть ясная цель.
Простой производственный процесс
- Определите аудиторию, сообщение, длительность и формат выдачи.
- Разделите концепт на несколько визуальных моментов вместо одного длинного описания.
- Используйте текст в видео для поиска, а изображение в видео для визуальной непрерывности.
- Генерируйте и утверждайте каждый ключевой план до перехода дальше.
- Соберите лучшие планы, затем добавьте звук, заголовки, субтитры и финальную проверку.
Такой подход подходит и отдельному автору, и команде, строящей повторяемый контент-процесс. Он отделяет творческие решения от технических итераций и делает обратную связь конкретной.
Чего ожидать от ИИ-видео сегодня
ИИ-видео ускоряет визуальные эксперименты, но не отменяет редакторское суждение. Лучшие результаты имеют ясный объект, сфокусированное действие и осознанные склейки. Сложные истории с несколькими героями, точные детали продукта и длинное непрерывное действие выигрывают от референсов, планирования и дополнительной проверки.
Полезнее спрашивать не о том, заменит ли ИИ всю продакшен-работу, а о том, где он помогает быстрее превратить идею в проверяемое визуальное направление.
Часто задаваемые вопросы
Какая технология лежит в основе генерации видео с ИИ?
Современные системы часто используют диффузионные модели, которые уточняют шум до кадров под управлением текста, изображения или видеореференса и моделируют связи кадров во времени.
Почему ИИ-видео иногда выглядит несогласованным?
Модель должна сохранять идентичность, окружение, свет и движение на многих кадрах. Неясные промпты, длинные сцены без склеек и отсутствие референсов усложняют задачу.
Что лучше: текст в видео или изображение в видео?
Текст в видео — сильный старт для новых идей. Изображение в видео обычно полезнее, когда визуальная идентичность человека, продукта или места должна остаться узнаваемой.
Заключение
Генерация видео с ИИ объединяет понимание языка, визуальный синтез и временное предсказание, превращая идею в движение. Четкое направление, разумное планирование планов и итеративный процесс дают лучшие результаты. Начните с одной сфокусированной сцены и развивайте ее дальше.
Связанные руководства
Продолжите с руководствами о создании видео по сценарию, ИИ-видео со звуком, длинных ИИ-видео и ИИ-видео для коротких фильмов. Технический контекст представлен в обзоре моделей диффузии для видео и документации Hugging Face Diffusers.