Como Funciona a Geração de Vídeo por IA
Entenda como a geração de vídeo por IA transforma texto e imagens em movimento, com modelos de difusão, consistência temporal e escolha de fluxo de trabalho.
Introdução
A geração de vídeo por IA transforma uma ideia escrita, uma imagem ou um clipe de referência em conteúdo visual em movimento. Em vez de animar cada quadro manualmente, criadores descrevem uma cena e orientam o modelo sobre sujeito, composição, movimento e atmosfera. O resultado pode ser um conceito rápido, um clipe social, um visual de produto ou parte de uma narrativa maior.
A tecnologia é poderosa, mas não é mágica. Um fluxo de trabalho útil começa com o entendimento de como o modelo interpreta um prompt, por que o movimento pode se desviar entre quadros e qual tipo de ferramenta combina com o trabalho.
Como a IA transforma ideias em movimento
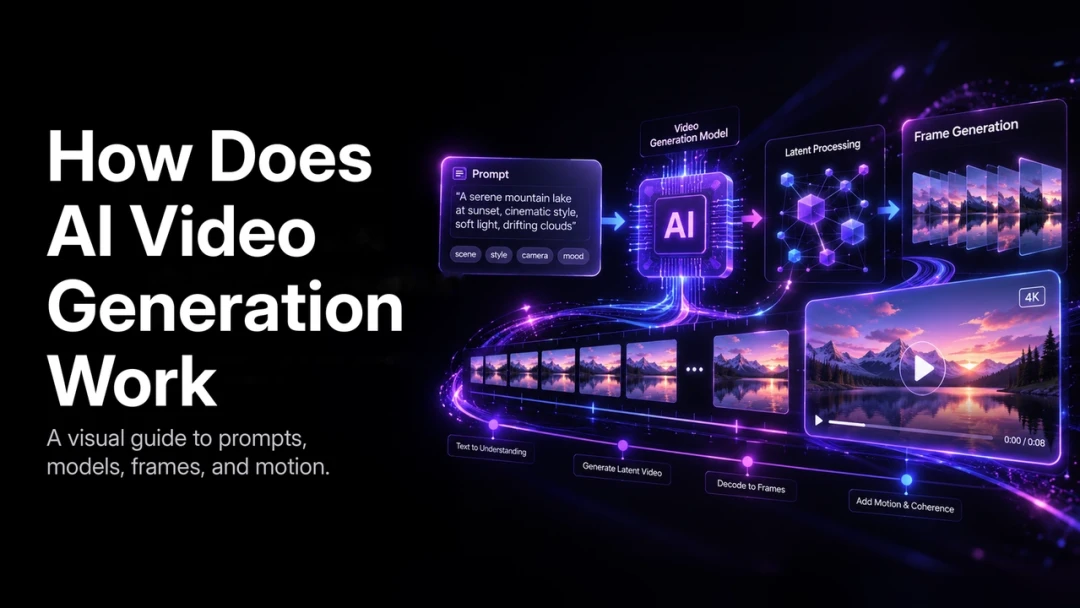
Um modelo de vídeo por IA conecta linguagem, aparência e tempo. O prompt fornece a intenção; imagens ou clipes de referência podem estabelecer detalhes visuais; em seguida, o modelo prevê uma sequência de quadros que torna sujeito e ação contínuos.
Por exemplo, “uma caneca de cerâmica em uma mesa de café em dia chuvoso, aproximação lenta, luz quente da janela” define sujeito, cenário, atmosfera e direção de câmera. Instruções específicas reduzem a ambiguidade, mas não garantem um primeiro resultado perfeito. A geração é iterativa: avalie o resultado, esclareça o prompt ou a referência e crie a próxima versão.
O papel dos modelos de difusão
Muitos sistemas modernos de texto para vídeo usam difusão. Eles começam com ruído visual e o removem gradualmente ao seguir o prompt. Em repetidas etapas de refinamento, cores, objetos, iluminação e movimento assumem a forma de um clipe coerente.
Ao contrário da animação quadro a quadro, um modelo de vídeo precisa raciocinar sobre o clipe como uma sequência. Ele deve preservar a aparência do sujeito enquanto prevê para onde ele se move em seguida. Esse raciocínio temporal é uma razão importante para a evolução do movimento e da câmera em vídeos de IA atuais.
Por que os prompts mudam o resultado
Prompts são direções, não roteiros de produção. O modelo pode inferir detalhes ausentes, mas a inferência pode diferir da intenção do criador. Um prompt forte normalmente descreve:
- O sujeito principal e referências visuais essenciais
- A ação e sua velocidade
- O cenário, horário e iluminação
- O enquadramento ou movimento de câmera
- O estilo e a proporção desejados
Comece pelo momento narrativo mais importante e adicione detalhes apenas quando aumentarem o controle. Uma lista longa de adjetivos desconectados pode tornar o resultado menos previsível.
Por que a consistência de movimento é difícil
Todo quadro precisa se conectar ao anterior. Se um rosto muda de forma, uma roupa muda de cor ou um objeto muda de posição sem motivo, o espectador percebe. Esses problemas são chamados de inconsistência temporal ou deriva visual.
O movimento também precisa de causa e efeito críveis. Quando uma pessoa se vira, corpo, roupa, sombras e perspectiva da câmera devem mudar juntos. Sequências longas, cenas cheias, movimentos rápidos de câmera e interações detalhadas ainda exigem direção e revisão cuidadosas.
Maneiras práticas de reduzir a deriva
- Use referência de personagem ou produto quando a identidade for importante.
- Mantenha sujeito, figurino, ambiente e iluminação estáveis entre planos relacionados.
- Gere um plano claro por vez e monte com os planos aprovados.
- Evite mudar estilo, linguagem de lente e descrição de sujeito ao mesmo tempo.
- Revise na velocidade normal; uma imagem estática pode ocultar problemas de movimento.
No PixVerse, os fluxos de texto para vídeo e imagem para vídeo oferecem pontos de partida diferentes. Texto serve para ideação aberta; referência de imagem costuma ser melhor quando um produto, personagem ou aparência precisa permanecer reconhecível.
Que tipo de ferramenta combina com seu projeto?
As ferramentas de vídeo por IA tendem a atender três casos de uso.
| Fluxo | Mais indicado para | Principal trade-off |
|---|---|---|
| Geração cinematográfica | Filmes de marca, curtas criativos, conceitos visuais | Requer mais trabalho de prompt e direção de planos |
| Vídeo com avatar | Treinamento, explicadores, apresentadores | Menor liberdade de narrativa visual |
| Produção por template | Conteúdo social ou de campanha repetível | Personalização mais limitada |
Fluxos cinematográficos priorizam enquadramento, atmosfera e movimento. Avatares funcionam quando um apresentador conduz a mensagem. Templates são eficientes quando a estrutura já está definida e a equipe precisa de muitas variações. Cada cena deve ter um propósito claro.
Um fluxo de produção simples
- Defina público, mensagem, duração e formato de entrega.
- Divida o conceito em alguns momentos visuais, em vez de uma descrição longa.
- Escolha texto para vídeo para explorar e imagem para vídeo para continuidade visual.
- Gere e aprove cada plano-chave antes de avançar.
- Monte os melhores planos e adicione som, títulos, legendas e revisão final.
Essa abordagem atende tanto um criador individual quanto uma equipe que constrói uma cadeia reutilizável de conteúdo. Ela separa decisões criativas da iteração técnica e torna o feedback concreto.
O que esperar do vídeo por IA hoje
Vídeo por IA torna a experimentação visual mais rápida, mas não elimina o julgamento editorial. Os melhores resultados têm sujeito claro, ação focada e cortes deliberados. Histórias complexas com vários personagens, detalhes exatos de produto e ação contínua longa se beneficiam de referências, planejamento de planos e mais revisão.
A pergunta útil não é se a IA pode substituir toda a produção, mas onde ela ajuda a levar uma ideia a uma direção visual testável mais rapidamente.
Perguntas frequentes
Qual é a tecnologia central da geração de vídeo por IA?
Sistemas modernos normalmente usam modelos baseados em difusão que refinam ruído em quadros guiados por um prompt de texto, imagem ou referência de vídeo e modelam como esses quadros se relacionam ao longo do tempo.
Por que alguns vídeos de IA parecem inconsistentes?
O modelo precisa preservar identidade, cenário, iluminação e movimento ao longo de muitos quadros. Prompts ambíguos, cenas longas sem cortes e referências ausentes tornam isso mais difícil.
Texto para vídeo ou imagem para vídeo é melhor?
Texto para vídeo é um ponto de partida forte para conceitos novos. Imagem para vídeo costuma ser mais útil quando a identidade visual de uma pessoa, produto ou lugar precisa continuar reconhecível.
Conclusão
A geração de vídeo por IA combina compreensão de linguagem, síntese visual e previsão temporal para transformar uma ideia em movimento. Direção clara, planejamento de planos e um fluxo iterativo produzem resultados melhores. Comece com uma cena focada, aprenda como o modelo responde e desenvolva a partir dela.
Guias relacionados
Continue com nossos guias sobre vídeo a partir de um roteiro, vídeo com áudio, vídeo de IA de formato longo e vídeo de IA para curtas-metragens. Para o contexto técnico, consulte a pesquisa sobre modelos de difusão de vídeo e a documentação Diffusers da Hugging Face.